Model A
Dowóz projektu od początku
Rozpoznanie, decyzje architektoniczne, backlog, widoczny loop budowy, launch i opieka po wdrożeniu - z seniorskim ownershipem technicznym od A do Z.
Wyszukiwarka
Szukaj po usługach, obszarach doświadczenia, technologii i proof.
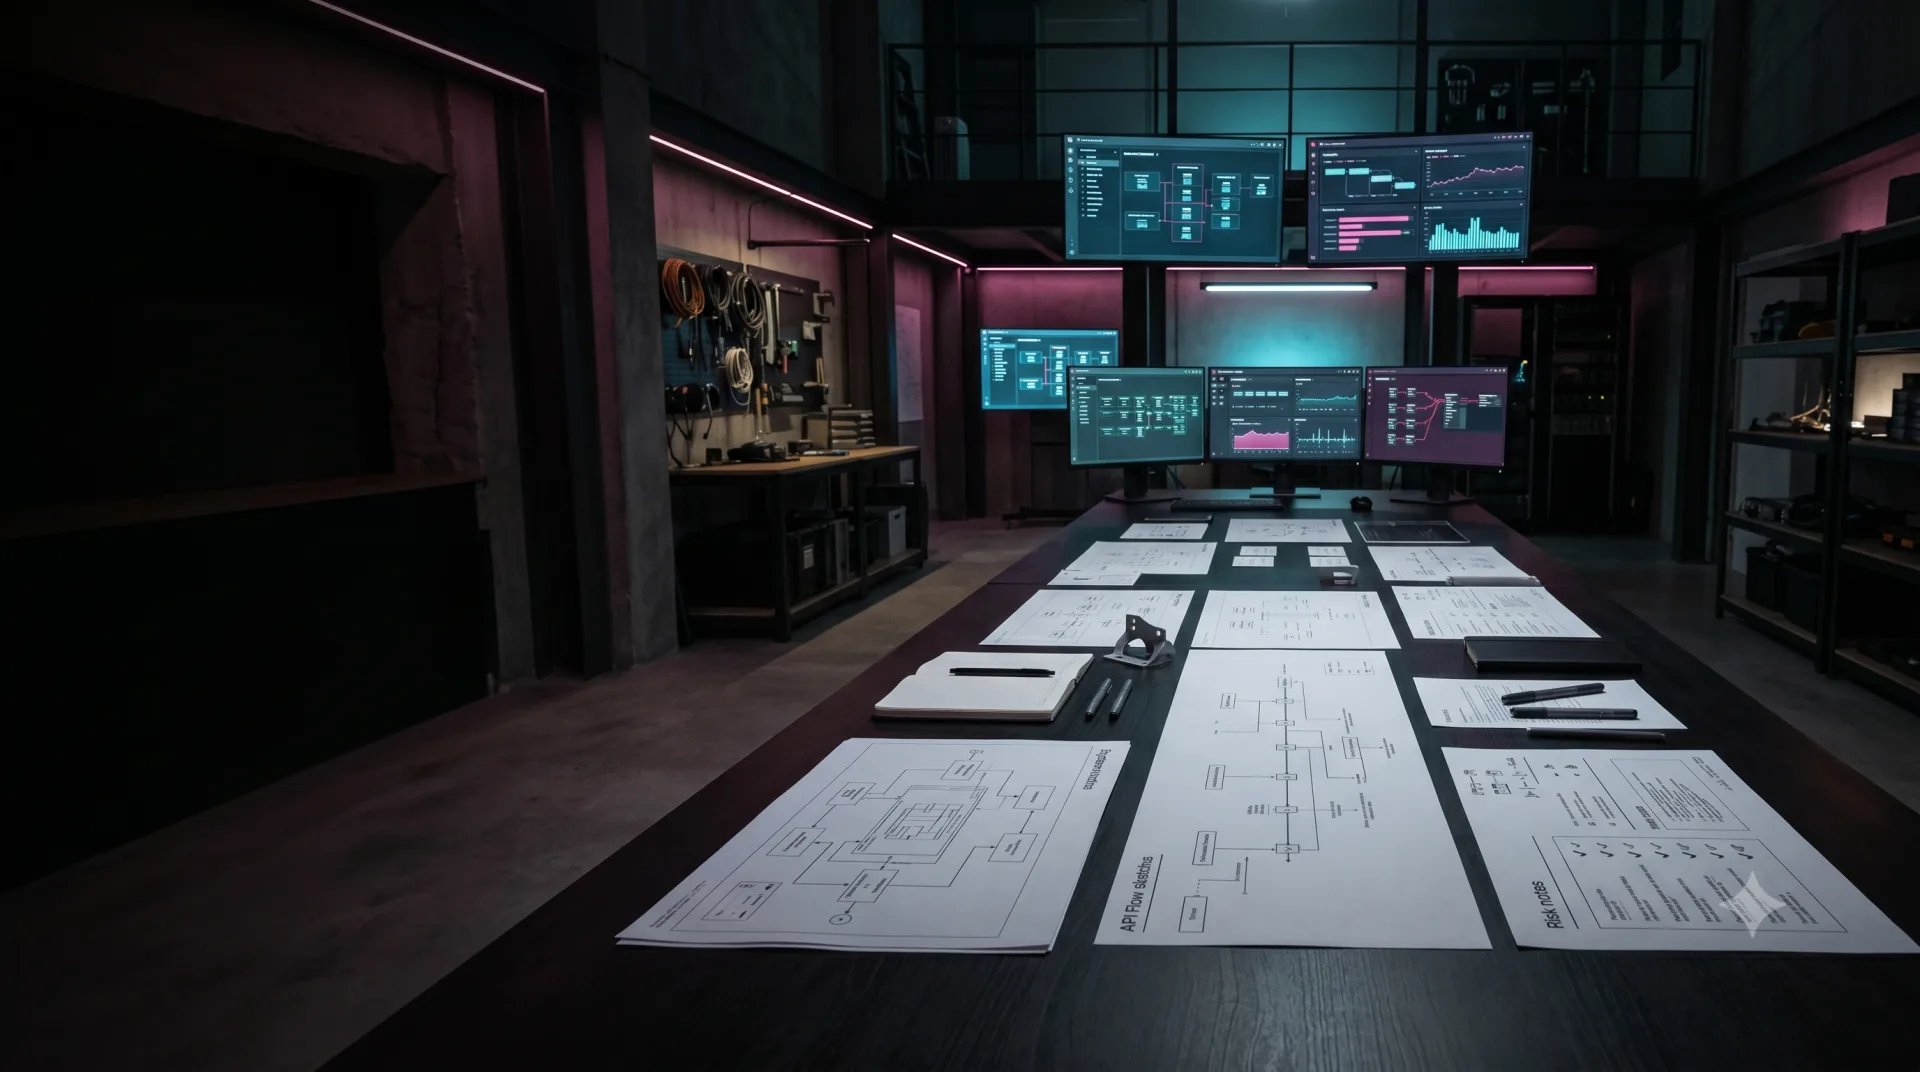
Ścieżka produkcyjna
Mapujemy workflow, izolujemy ryzyko, dowozimy przyrosty i robimy rollout z kontrolą - zamiast liczyć, że release się zachowa.
Kręgosłup delivery
Konkretna, żeby zmniejszać ryzyko. Elastyczna wobec bałaganu, który jest normalny. Każdy etap zostawia coś po Twojej stronie.
Ręczna praca, kruche integracje, wolne handoffy, brak ownershipu, incydenty produkcyjne i dane, którym nikt nie ufa.
Który problem warto rozwiązać najpierw, kto od niego zależy i jakiego ryzyka produkcyjnego nie wolno zignorować.
Czytelne ujęcie problemu i pierwsze pytania techniczne do sprawdzenia.
Ludzi, systemy, API, pliki, kolejki, arkusze, wyjątki, role, uprawnienia i ręczne kroki awaryjne.
Gdzie zakres się zaczyna, gdzie kończy, które dane są źródłem prawdy i które przekazania wymagają kontroli.
Mapę workflow i systemu, która zamienia chaotyczny kontekst w budowalny zakres.
Integrację, migrację, model danych, workflow AI, bottleneck performance, edge autoryzacji albo ścieżkę deploy.
Co trzeba zwalidować, zanim projekt urośnie, i jaki sygnał akceptacji pokaże, że to działa.
Skupiony spike techniczny, notatkę architektoniczną albo plan prototypu dla ryzykownego wycinka.
Najmniejszy fragment workflow, który daje realną wartość operacyjną i dotyka ważnych granic systemu.
Kolejność release, pokrycie testami, ścieżkę review, potrzeby migracji danych i co na razie zostaje ręczne.
Działające przyrosty, review zmian, notatki QA i widoczne tradeoffy.
Dane stagingowe, ścieżkę deploymentu, smoke checki, monitoring, rekoncyliację, rollback i gotowość zespołu.
Moment launchu, kryteria akceptacji, kontrole operacyjne i kto obserwuje co po release.
Plan release, kontrole produkcyjne, dokumentację i rollout, który da się obserwować.
Sygnały monitoringu, feedback użytkowników, logi wyjątków, pytania supportu, drift danych i następny punkt presji.
Co wymaga strojenia, co można przekazać zespołowi i które usprawnienie powinno być następne.
Opiekę po launchu, transfer wiedzy i praktyczny backlog kolejnych kroków.
Modele współpracy
Czasem potrzebujesz całego projektu, czasem seniora w istniejącym zespole. Standard jest ten sam: jasny zakres, widoczne przyrosty, odpowiedzialność za produkcję.
Rozpoznanie, decyzje architektoniczne, backlog, widoczny loop budowy, launch i opieka po wdrożeniu - z seniorskim ownershipem technicznym od A do Z.
Wchodzimy w Twoje narzędzia i standardy, dowozimy pierwszy użyteczny pull request szybko, potem trzymamy rytm zespołu i jakość kodu.
Następny krok
Na początek wystarczy zarys procesu, systemu i ograniczeń.